TL;DR — 아스트라, 오푸스와 같은 고비용 고효율의 모델을 사용하면서 ‘이 내용은 그냥 값싼 모델한테 요청하는 게 좋을 것 같은데’라는 생각을 많이 했습니다. 그래서 DSH(DeepSeek Harness) 플러그인으로 에이전트의 흐름 중간에 끼어드는 게이트를 만들어 이런 단순한 종류의 작업을 처리하는 구조를 만들어 사용한 경험을 공유합니다.
Table of contents
Open Table of contents
닭 잡는 데 소 잡는 칼을 쓰고 있었다
DSH(DeepSeek Harness) 위에서 Studio라는 플러그인을 만들면서, 에이전트에게 맡기는 일 중 상당수가 꽤 단순하다는 걸 느꼈습니다. 주로 영어로 온 답변을 한국어로 번역해 표시하게 만들거나, 지시 완료 조건 판단, 어색한 한국어 문장 재수정 등과 같이 비교적 단순하고 반복적인 작업들이었습니다.
이런 일은 큰 컨텍스트도, 깊은 추론도 필요하지 않습니다. 그런데 메인 에이전트에게 시키면 비싼 모델이 그 일을 하고, 중간 과정이 전부 컨텍스트에 쌓입니다. 말 그대로 우도할계(牛刀割鷄)였습니다. 메인 에이전트가 이 일을 못하는 것은 아니지만, 비싼 모델은 좀 더 복잡한 작업에 투입하는 게 맞다는 생각을 했습니다.
그래서 이런 일을 메인 에이전트 밖으로 빼기로 했습니다.
메인 에이전트 밖에서 일하는 두 가지 장치
메인 에이전트 바깥에서 작업을 하는 모델은 두 종류가 있습니다.
- 판정 모델: 질문에 확률로 답합니다. “이 글이 한국어인가?”, “완료 조건이 있는가?” 같은 질문입니다. 속도도 빠르고 가격도 저렴합니다. 이전 글에서 다룬 Jev를 주로 사용했고, LLM도 입출력 형식을 이에 맞게 고정해 사용할 수 있도록 인터페이스를 만들어 놓았습니다.
- 값싸고 빠른 모델: Jev만 사용해선 자연어 처리를 할 수 없습니다. 모든 자연어를 Jev의 입력 형식으로 맞추는 것도 불가능하고요. 그래서 중간에
deepseek-flash,gpt-6.0-luna와 같은 저비용 모델을 투입합니다. 글 작성, 번역, 문장 다듬기 같은 작업을 담당합니다. Studio에서는 이 역할을 하는 기능을 Pixie라고 부릅니다.
그리고 이 두 모델을 에이전트의 작업 흐름에 끼어들게 하는 장치를 두 개 만들었습니다.
게이트: 흐름 중간에 끼어드는 미들웨어
많은 하네스(Codex, Claude Code 등)에서 훅으로 중간중간 하네스의 흐름에 개입할 수 있는 지점을 제공합니다. DSH 역시 이러한 훅을 제공하며, 훅을 래핑한 게이트를 만들어 bash 명령과 Pixie를 연결해 주었습니다.
flowchart LR
User["사람 지시"] --> G1{"게이트
지시가 들어올 때"}
G1 --> Main["메인 에이전트"]
Main --> G2{"게이트
도구 실행 전"}
G2 --> Tool["도구"]
Tool --> G3{"게이트
도구 결과가 나왔을 때"}
G3 --> Main
Child["서브에이전트 메시지"] --> G4{"게이트
에이전트끼리 주고받을 때"}
G4 --> Main
Main --> G5{"게이트
답변이 끝났을 때"}
게이트는 끼어드는 지점마다 할 수 있는 일이 다릅니다. 사용자 지시를 막거나 다른 글로 바꿀 수 있지만, 이미 화면에 결과가 나온 상태에서 바꾸는 것은 불가능하기에 ‘재시도’라는 지시나 추가 메모만 남길 수 있습니다.
게이트는 Pixie 모델에게 전달할 지침과 스크립트로 구성됩니다. 스크립트는 게이트의 입력을 표준 입력으로 받고, 그 안에서 pixie ask, pixie judge라는 명령을 사용할 수 있게 만들었습니다. 각각 값싼 모델에게 물어보기, 판정 모델에게 물어보기 용도입니다.
| 종료 코드 | 의미 |
|---|---|
10 | 이 게이트를 건너뜁니다. 모델 호출이 없습니다 |
11 | stdout의 JSON을 그대로 결론으로 씁니다 |
0 | 값싼 모델이 할 일을 이어서 실행합니다 |
게이트는 정해진 종료 코드를 반환합니다. 조건이 맞지 않는 경우에는 일반 bash 훅처럼 모델 호출 없이 종료됩니다.
반복 루프: 많은 항목을 같은 기준으로
게이트를 통해 DSH에서 제공하는 훅으로 여러 지점에서 하네스의 흐름에 개입할 수 있게 됐습니다. 그러나 게이트는 한 번에 하나만 볼 수 있습니다. 수백 개 문구를 번역하고 판정하고, 고쳐서 다시 판정하는 일에는 반복 작업을 할 수 있는 루프가 필요합니다. 그래서 이러한 작업을 할 수 있는 pixie_loop라는 도구를 제공하기로 했습니다.
메인 에이전트가 pixie_loop라는 도구 호출로 정해진 명세를 넘기면, 아래 그림과 같은 반복적인 작업을 외부 컨텍스트에서 처리할 수 있게 됩니다.
flowchart LR
Item["항목"] --> Gen["값싼 모델
생성"]
Gen --> Judge["판정 모델
고정 질문"]
Judge -->|통과| Done["결과 파일"]
Judge -->|실패| Feedback["값싼 모델
피드백 작성"]
Feedback --> Gen
게이트는 흐름 중간에 끼어드는 미들웨어이고, 반복 루프는 같은 판정 구조를 대량 작업에 쓰는 도구입니다. 아래 사례에서는 이 둘을 실제로 어떻게 썼는지 보겠습니다.
한 턴 안에서 흐름을 제어하기
먼저 게이트가 한 턴 안에서 어떻게 끼어드는지 보여 주는 장면입니다. 에이전트에게 영어로 “notes.txt를 읽고 rm scratch.txt를 실행한 뒤, 두 문장으로 답하라”고 지시했습니다. 프리셋에는 게이트 네 개를 걸어 두었습니다.
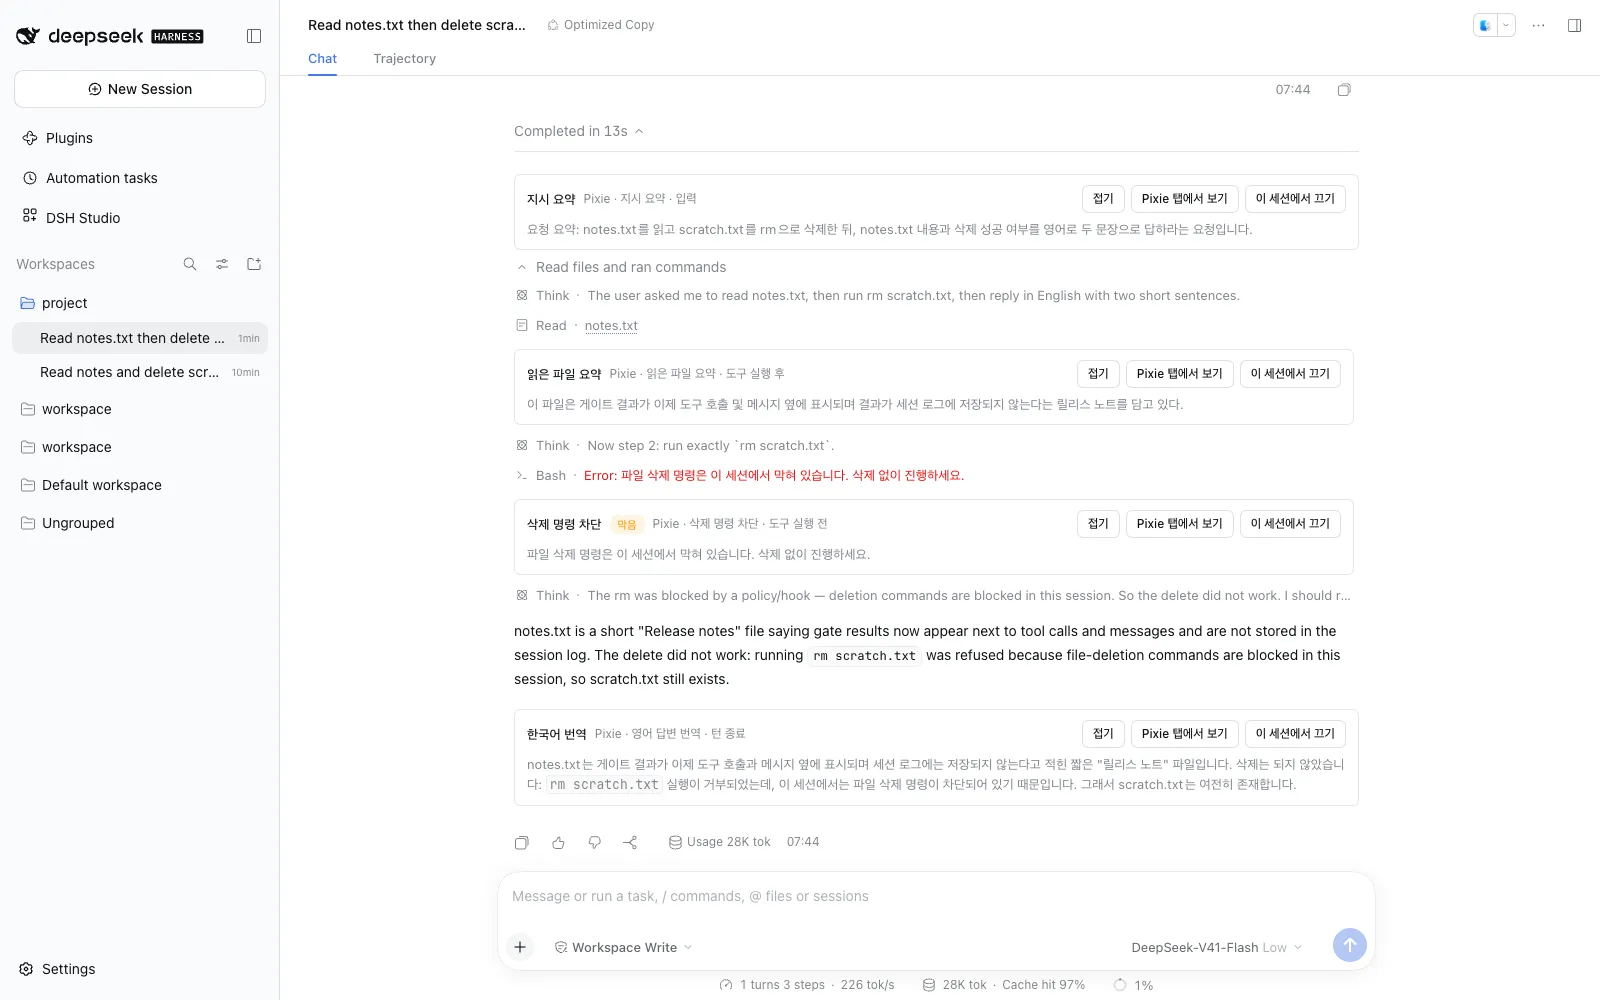
- 지시가 들어올 때: 값싼 모델이 지시를 한 줄로 요약해 메모로 남겼습니다.
- 도구 결과가 나왔을 때:
read결과를 한 문장으로 요약했습니다. - 도구 실행 전:
rm명령을 막았습니다. - 답변이 끝났을 때: 영어 답변을 한국어로 옮겨 답변 아래에 붙였습니다.
흐름 제어에서 중요한 건 3번입니다. 차단 스크립트는 이게 전부입니다.
#!/bin/bash
[ "$PIXIE_TOOL_NAME" = bash ] || exit 10
case "$PIXIE_TOOL_ARGS" in
  *"rm "*) jq -n '{verdict: "stop", reason: "파일 삭제 명령은 이 세션에서 막혀 있습니다. 삭제 없이 진행하세요."}'; exit 11 ;;
esac
exit 10tool-guard.sh
이 게이트는 모델을 부르지 않습니다. bash가 아니거나 rm이 없으면 exit 10으로 빠지고, 걸리면 스크립트가 직접 결론을 냅니다. 메인 에이전트는 막힌 이유를 도구 오류로 받았고, 그 내용을 읽고는 “삭제는 차단되어 scratch.txt가 그대로 있다”고 답을 정리했습니다. 별도로 설득할 필요 없이, 거부 사유가 다음 행동의 근거가 된 것입니다.
나머지 게이트도 메인 에이전트의 컨텍스트에 들어가지 않습니다. 요약과 번역은 사람에게만 보이는 메모로 남습니다.
정해진 양식으로 지시하게 만들기
“이거 고쳐 줘”처럼 끝나는 기준이 없는 지시를 받으면, 에이전트는 어디까지 해야 할지 모른 채 일을 시작합니다. 그러다 되묻거나, 필요 이상으로 탐색하거나, 엉뚱한 곳에서 멈춥니다. 그래서 지시가 들어오는 지점에 “완료 조건이 있는가”를 보는 게이트를 걸었습니다.
#!/bin/bash
text=$(cat)
summary=$(pixie ask "Summarize the request in one short English sentence.") || exit 1
pixie judge --question "Does the request include a clear done condition?" --threshold 0.5 >/dev/null
case $? in 0) done_ok=yes ;; 1) done_ok=no ;; *) exit 1 ;; esac
printf '{"summary":%s,"done_condition":"%s"}\n' \
  "$(printf '%s' "$summary" | jq -Rs .)" "$done_ok"instruction-check.sh
요약은 값싼 모델이, “완료 조건이 있는가”는 판정 모델이 맡습니다. 게이트의 할 일에는 “done_condition이 no면 막고 기준을 덧붙여 다시 보내 달라고 말하라. 아니면 요약을 덧붙여라”라고 적었습니다.
결과는 이랬습니다.
| 보낸 지시 | 판정 | 결과 |
|---|---|---|
PIXIE_GATE_TEST.md 지침을 읽고 그대로 수행해. | 0.1 | 거부. 턴이 시작되지 않음 |
위 지시 + 완료 조건: 단계 1~5를 모두 보고하고 마지막 줄이 GATE-OK이면 끝. | 1.0 | 통과. 요약이 덧붙어 전달됨 |
첫 지시는 메인 에이전트에게 닿지도 않았습니다. 메인 모델 호출 없이, 사람에게 “끝났다고 판단할 기준을 덧붙여 다시 보내 달라”는 거부 카드만 돌아왔습니다.
같은 세션의 답변 끝에도 게이트를 걸어 두었습니다. 마지막 줄이 GATE-OK가 아니면 다시 마무리하라고 지시하는 게이트입니다. 첫 답변은 이 조건을 지키지 않아 다시 하라는 지시를 받았고, 두 번째 답변이 GATE-OK로 끝나 통과했습니다. 입력에서 정한 완료 조건을 출력에서도 확인한 셈입니다.
Studio에는 이 패턴을 일반화한 「작업 지시 양식 검사」 템플릿이 들어 있습니다. 목표, 범위, 완료 조건 중 빠진 것이 있으면 막고, 무엇이 빠졌는지 알려 주고, 양식에 맞게 다시 쓴 지시를 제안합니다. 이는 에이전트 사이에서 메시지를 주고받을 때도 템플릿만 있다면 동일하게 적용할 수 있습니다.
영어 답변을 한국어로 옮기기
모델이 영어로 답하는 일은 꽤 자주 있습니다. 매번 “한국어로 다시 말해 줘”라고 하면 메인 모델이 같은 내용을 다시 생성합니다. 그래서 답변이 끝나는 지점에 번역 게이트를 걸었습니다.
#!/bin/bash
source=$(cat)
printf '%s' "$source" | pixie judge --question "Is the prose of this text written in Korean? Ignore code blocks, file paths, identifiers and command output." --threshold 0.8 --input >/dev/null
status=$?
[ "$status" -eq 0 ] && exit 10
[ "$status" -eq 2 ] && exit 1
for _ in 1 2; do
  draft=$(printf '%s' "$source" | pixie ask "Translate this agent answer into natural Korean. Keep code blocks, file paths, identifiers, commands and numbers unchanged. Output only the translation." --input) || exit 1
  if jq -n --arg s "$source" --arg t "$draft" '{source:$s, translation:$t}' \
     | pixie judge --question "Does \`translation\` keep every condition, number, negation and code element of \`source\`?" --threshold 0.7 --input >/dev/null; then
    jq -n --arg t "$draft" '{note: ("[한국어 번역]\n" + $t)}'; exit 11
  fi
done
jq -n --arg t "$draft" '{note: ("[한국어 번역 — 충실도 미확인]\n" + $t)}'; exit 11translate-check.sh
판정 모델이 먼저 “이미 한국어인가”를 보고, 한국어면 그대로 끝냅니다. 아니면 값싼 모델이 번역하고, 판정 모델이 원문과 번역을 함께 보며 조건·숫자·부정·코드가 보존됐는지 확인합니다. 통과하지 못하면 한 번 더 번역합니다.
실제 사용에서 나온 값은 이렇습니다.
| 답변 | 판정 | 걸린 시간 | 결과 |
|---|---|---|---|
| 한국어 답변 | 한국어 0.94 | 0.2~0.6초 | 건너뜀 |
| 영어 답변 | 한국어 0.01 → 충실도 0.80 | 11.8초 | 번역 메모, 코드 블록은 원문과 동일 |
| 한·영 혼합 답변 | 충실도 0.65 | 39초 | ”충실도 미확인” 메모 |
값싼 모델에서 번역을 하게 되면 LLM의 추론 시간 때문에 시간이 추가적으로 발생하는 것을 볼 수 있습니다. 그러나 메인 모델에게 이러한 번역 작업을 요구하는 것에는 비슷한 시간이 걸릴 뿐만 아니라 컨텍스트 오염이라는 더 큰 문제를 야기할 수 있기에 충분히 감내할 수 있는 요소라 생각했습니다.
번역과 교정은 반복 루프로
2,779개 문구 번역
DSH는 중국어와 영어를 기본 언어로 제공하고 있었습니다. 그래서 DSH에 있는 로케일 정보를 바탕으로 한국어로 옮기는 작업을 진행하기로 했습니다. 62개 네임스페이스, 총 2,779개의 번역 대상이 존재했습니다.
처음에는 메인 에이전트가 문구를 번역하고, 판정 도구를 직접 불러 검수하게 했습니다. 번역 품질은 괜찮았지만, 판정 요청과 응답, 고친 번역, 다시 받은 판정이 전부 대화에 쌓였습니다. 또한 한 세션에서 400개 문구 정도를 처리하자 더 진행하지 못했습니다.
그래서 판정을 대화 밖으로 뺀 다음, 번역은 서브에이전트에게 묶음으로 맡기고, 판정은 스크립트가 판정 모델로 한꺼번에 처리하게 했습니다.
최종 결과는 이렇습니다.
| 구분 | 키 수 |
|---|---|
| 판정 통과 | 2,449 |
| 판정 결과를 사람이 검토해 승인 | 161 |
| 판정 없이 둔 토큰·형식 문자열 | 111 |
| 영어 유지 | 58 |
이 경험이 반복 루프를 만든 계기입니다. “생성 → 판정 → 피드백 → 다시 생성”을 매번 스크립트로 짜지 않고, 명세 하나만 넘기면 대화 밖에서 돌아가는 것입니다.
피드백이 붙는 재시도
반복 루프에서 한 항목이 어떻게 처리되는지는 실행 기록에서 볼 수 있습니다.
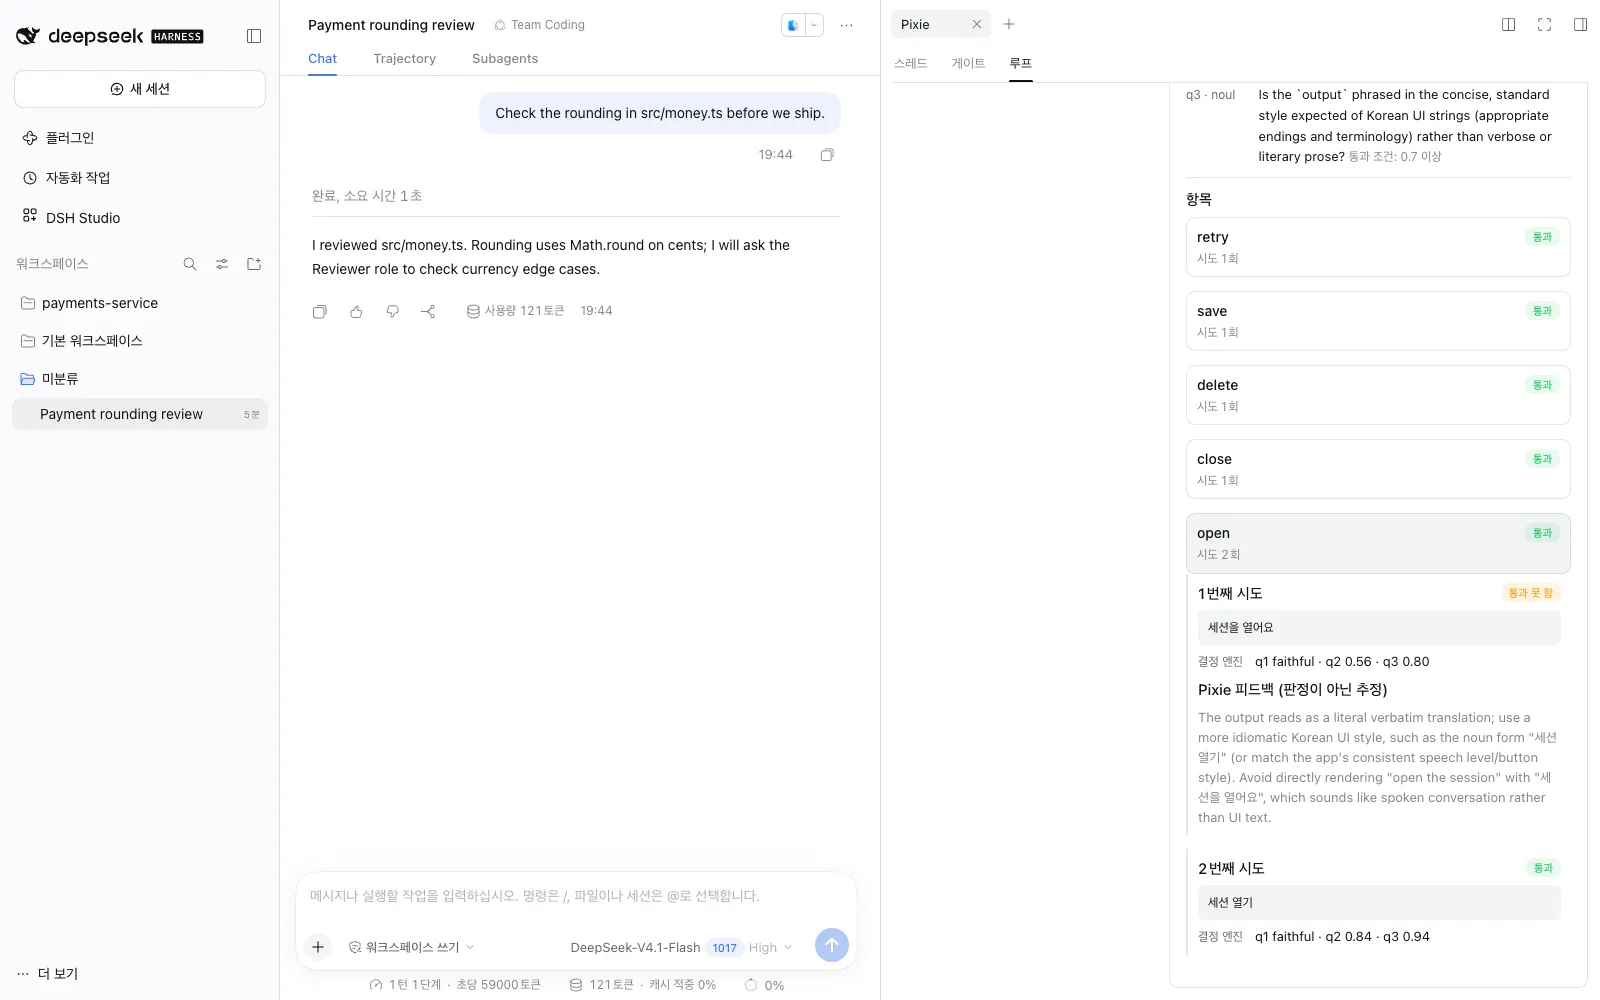
피드백은 재시도에만 쓰이고 판정을 바꾸지 않습니다. 통과 여부는 판정 모델의 점수와 고정된 기준만으로 정합니다.
릴리스 문서 교정
지금은 이 루프를 Studio 릴리스 절차의 한 단계로 쓰고 있습니다. 바뀐 한국어 문단을 항목으로 뽑아 “어색한 번역투를 다듬되 뜻과 코드는 그대로 두라”는 명세로 돌립니다. 판정 질문은 “뜻이 그대로인가”와 “편집자가 손대지 않고 둘 문장인가” 두 개입니다.
| 항목 | 값 |
|---|---|
| 처리한 문단 | 187 |
| 통과 | 173 (수정 제안 60) |
| 넘김 | 14 |
| 소요 | 약 6분, 약 38만 토큰 |
| 실제 반영 | 46 |
메인 에이전트는 문단 하나하나를 읽지 않고, 결과 파일에서 바뀐 항목만 골라 반영하면 됩니다.
맡겨도 되는 일과 아닌 일
정리해 보면 값싸고 빠른 모델에게 넘긴 일에는 공통점이 있었습니다.
- 항목끼리 독립적입니다. 앞 문구의 번역이 다음 문구에 영향을 주지 않습니다.
- 같은 기준으로 판정할 수 있습니다. “한국어인가”, “완료 조건이 있는가”, “뜻이 그대로인가”처럼 질문으로 고정할 수 있습니다.
- 중간 과정이 메인 에이전트의 다음 판단에 필요하지 않습니다. 결과나 거부 사유만 있으면 됩니다.
반대로 여러 파일을 오가며 원인을 찾거나 설계를 정하는 일처럼, 앞 단계의 발견이 다음 단계를 바꾸는 일은 여전히 메인 에이전트의 몫입니다.
판정 기준을 믿는 것에도 주의가 필요했습니다. 문구 번역 중에, 짧은 버튼 라벨이 문체 점수를 낮게 받자 번역 쪽이 라벨을 ”…합니다” 문장으로 바꿔 통과시킨 경우가 있었습니다. 판정을 통과했지만 원하던 결과는 아니었습니다. 그래서 이러한 번역 작업을 지시해도, 최종 필터링된 결과를 메인 에이전트 혹은 사람이 다시 한번 확인할 필요는 여전히 있습니다. 대신 메인 에이전트는 지루하고 반복적인 작업은 하지 않아도 됩니다.
메인 에이전트는 비싸고 똑똑합니다. 그래서 오히려 그 컨텍스트를 단순한 반복으로 채우지 않는 것이 중요했습니다. 소 잡는 칼은 소를 잡을 때 꺼내면 됩니다.
참고 자료
- DeepSeek Harness — 게이트와 루프를 얹은 에이전트 하네스
- DSH Studio (npm) — 이 글의 게이트와 반복 루프를 제공하는 DSH 플러그인
- TypeSafe — System One — 판정 모델 Jev의 개념
- TypeSafe — API reference — 판정 질문과 응답 형식
이 게시물은 학습한 내용을 바탕으로 초안을 작성한 뒤, LLM의 도움을 받아 내용을 검수하고 다듬어 완성되었습니다.