Table of contents
Open Table of contents
1. 확인하고 싶었던 내용
Jev를 게임에서 NPC에 사용할 수 있는 능동적인 판단 기계로 사용할 수 있나 궁금했습니다.
단편적인 질문에 대해 Jev는 일반적으로 합리적인 선택을 하지만, 그리디한 선택이 항상 최선의 답을 가져오지 않는 상황에서도 Jev의 선택을 신뢰하고 NPC의 AI로 사용할 수 있나 실험해보기 위해 뱀주사위 게임을 Jev로 플레이하게 해보았습니다.
2. 뱀주사위 게임판과 실행 조건
| 항목 | 설정 |
|---|---|
| 모델 | jev-1.13.0 |
| 출발 / 목표 | 1번 / 100번 |
| 행동 | 매 턴 주사위 눈 1~6 중 하나를 직접 선택 |
| 이동 | 선택한 눈만큼 전진하고, 도착 칸의 특수 이동을 같은 턴에 적용 |
| 종료 | 정확히 100에 도착하거나 100턴 상한에 도달 |
| 선택 제한 | 100을 넘는 눈은 제외 |
| 실행할 행동 | 응답의 choice를 그대로 적용 |
| 목표 지시 | 이후 턴을 포함해 가능한 적은 턴으로 100에 도착 |
- 무작위로 주사위를 굴리는 대신
Jev가 직접 눈을 선택합니다. Jev응답의probabilities는 기록했지만 행동 추첨에는 사용하지 않았습니다.
이번 실험에서는 2개의 다른 게임판을 준비했습니다.
depth0: 최단 경로에 후퇴 한 번이 포함된 상황
특수 이동은 6→60, 61→20, 22→100입니다.
| 턴 | 현재 위치 | 선택한 눈 | 도착 → 최종 위치 |
|---|---|---|---|
| 1 | 1 | 5 | 6 → 60 |
| 2 | 60 | 1 | 61 → 20 — 후퇴 |
| 3 | 20 | 2 | 22 → 100 |
최단 경로는 3턴입니다. 후퇴를 피하면 최소 4턴입니다.
depth1: 최단 경로에 후퇴 두 번이 포함된 상황
특수 이동은 6→60, 61→20, 22→80, 81→40, 42→100입니다.
| 턴 | 현재 위치 | 선택한 눈 | 도착 → 최종 위치 |
|---|---|---|---|
| 1 | 1 | 5 | 6 → 60 |
| 2 | 60 | 1 | 61 → 20 — 후퇴 |
| 3 | 20 | 2 | 22 → 80 |
| 4 | 80 | 1 | 81 → 40 — 후퇴 |
| 5 | 40 | 2 | 42 → 100 |
최단 경로는 5턴입니다. 두 후퇴 중 하나를 피하면 최소 6턴입니다. 최단 경로는 코드의 너비 우선 탐색으로 계산했습니다.
3. 전체 보드 제공
처음 실험은 Jev가 게임판에 존재하는 특수 이동을 모두 알고 있는 상황에서 어떤 선택을 하는지 확인하기 위해 Jev의 입력에 모든 특수 이동에 대한 정보를 포함하도록 만들었습니다.
확인 목적: 전체 상황과 이번 턴의 이동 결과를 알고 있을 때, 즉시 전진보다 후퇴가 유리한 경로를 선택하는지 확인합니다.
예측: 후속 연결을 고려해 최단 경로를 선택한다면 depth0에서는 3턴, depth1에서는 5턴에 도착합니다.
입력: 현재 위치, 전체 특수 이동, 이동 규칙, 각 눈의 도착 칸과 특수 이동 적용 후 최종 위치를 제공합니다. 나머지 칸에는 특수 효과가 없다고 명시합니다. 후속 경로와 남은 최단 턴은 제공하지 않습니다. 회차별 행동 이력은 전달하지 않습니다.
{
  "model": "jev-1.13.0",
  "state": {
    "current_position": 60,
    "goal_position": 100,
    "board": {
      "first_square": 1,
      "last_square": 100,
      "transitions": [
        {
          "from": 6,
          "to": 60
        },
        {
          "from": 61,
          "to": 20
        },
        {
          "from": 22,
          "to": 100
        }
      ]
    },
    "rules": [
      "Each turn, choose a die value from 1 to 6.",
      "Move forward from your current position by the chosen value.",
      "If you land on a transition's from square, immediately move to its to square during the same turn. This transition is mandatory.",
      "All other squares have no special effect.",
      "A move that would exceed square 100 is not allowed.",
      "Finish by reaching square 100 exactly.",
      "You may choose a die value again on every subsequent turn."
    ],
    "immediate_outcomes": {
      "1": {
        "landing_position": 61,
        "final_position": 20
      },
      "2": {
        "landing_position": 62,
        "final_position": 62
      },
      "3": {
        "landing_position": 63,
        "final_position": 63
      },
      "4": {
        "landing_position": 64,
        "final_position": 64
      },
      "5": {
        "landing_position": 65,
        "final_position": 65
      },
      "6": {
        "landing_position": 66,
        "final_position": 66
      }
    }
  },
  "questions": {
    "die": {
      "type": "choice",
      "instructions": "Choose the die value that allows you to reach square 100 in the fewest total turns, including subsequent turns.",
      "criteria": {
        "1": "Roll 1.",
        "2": "Roll 2.",
        "3": "Roll 3.",
        "4": "Roll 4.",
        "5": "Roll 5.",
        "6": "Roll 6."
      }
    }
  }
}
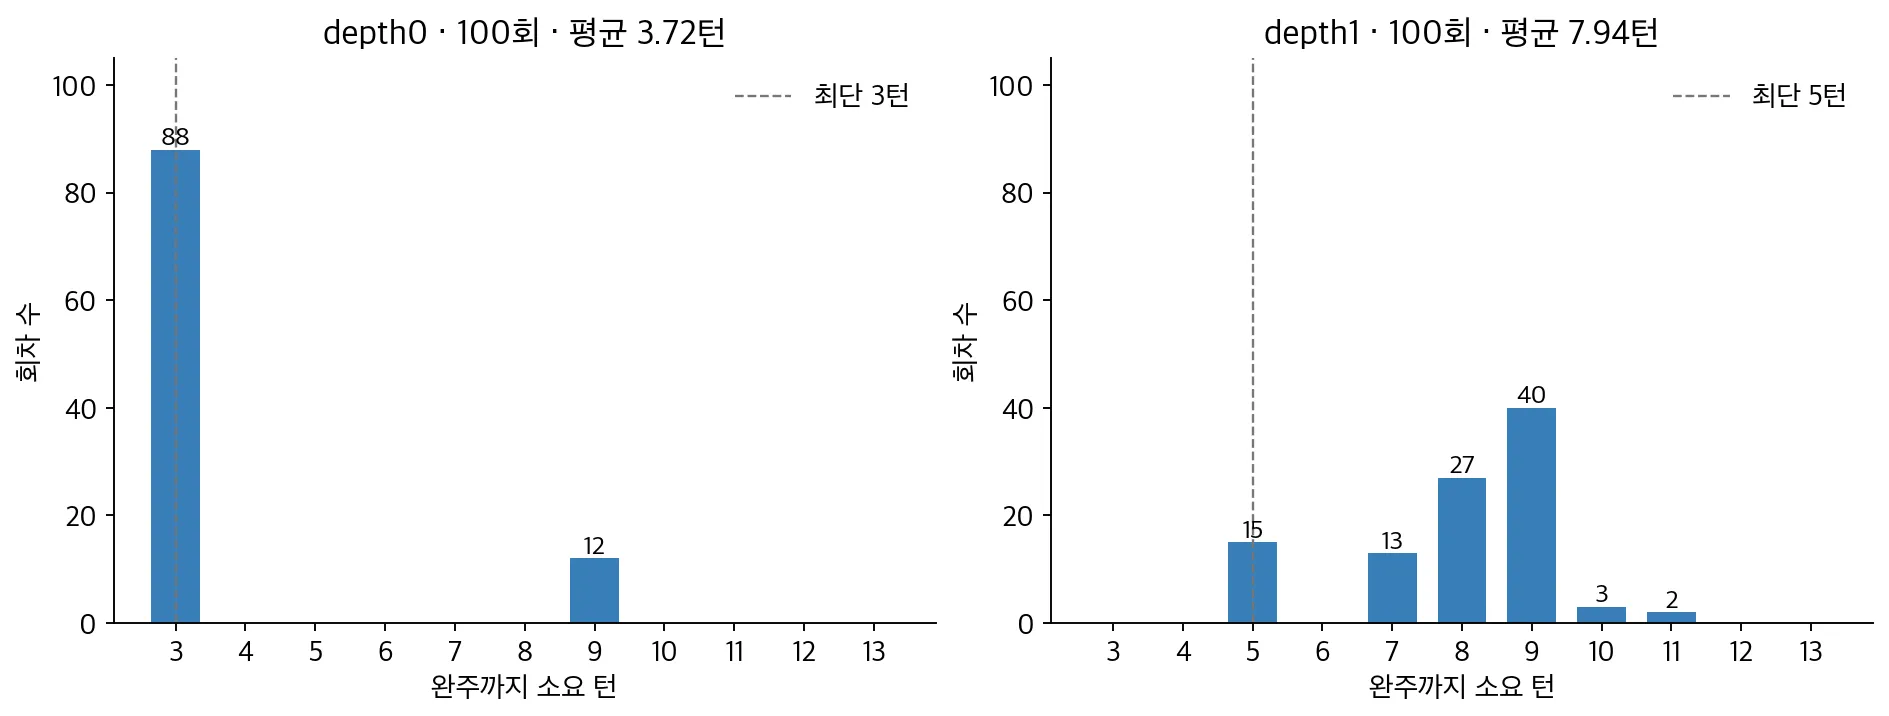
결과: 보드별 100회, 동시 실행 5개로 진행했습니다.
| 보드 | 완주 | 평균 턴 | 최단 경로 완주 | 소요 턴별 횟수 |
|---|---|---|---|---|
depth0 | 100/100 | 3.72 | 88/100 | 3턴 88회, 9턴 12회 |
depth1 | 100/100 | 7.94 | 15/100 | 5턴 15회, 7턴 13회, 8턴 27회, 9턴 40회, 10턴 3회, 11턴 2회 |
4. 정보 누적과 단계별 공개
이번에는 특수 이동 정보를 모르는 상태에서 시작해, 제공 정보를 늘리며 테스트했습니다. depth0에서 직접 발견한 정보를 누적하는 실험을 먼저 진행했고, 이후 depth0와 depth1에서 연결을 하나씩 공개했습니다.
4.1 직접 발견한 정보 누적
확인 목적: 전체 보드를 모르는 상태에서 직접 발견한 연결을 다음 턴과 회차에 전달했을 때, 경로와 완주 턴이 달라지는지 확인합니다.
예측: 발견 정보가 늘고 그 정보를 후속 경로 선택에 활용한다면, 이후 회차의 완주 턴이 줄어들 것으로 예상했습니다.
입력: depth0에서 기억 없이 시작합니다. 실제 도착한 칸의 특수 이동만 memory.known_transitions에 추가합니다. 일반 칸과 지나친 칸은 기억에 넣지 않습니다. 각 눈의 도착 칸은 제공하지만, 이동 후 최종 위치는 이미 발견한 연결에 대해서만 제공합니다. 완주 후 위치만 1로 초기화하고 기억은 유지합니다.
{
  "model": "jev-1.13.0",
  "state": {
    "current_position": 20,
    "goal_position": 100,
    "rules": [
      "Each turn, choose a die value from 1 to 6.",
      "Move forward by the chosen value.",
      "Some squares have a mandatory transition to another square, applied immediately during the same turn.",
      "Transitions are fixed throughout all plays.",
      "A square absent from memory is not confirmed to have no transition.",
      "Moves beyond square 100 are not allowed.",
      "Finish by reaching square 100 exactly."
    ],
    "memory": {
      "known_transitions": [
        {
          "from": 61,
          "to": 20
        }
      ]
    },
    "available_moves": {
      "1": {
        "landing_position": 21
      },
      "2": {
        "landing_position": 22
      },
      "3": {
        "landing_position": 23
      },
      "4": {
        "landing_position": 24
      },
      "5": {
        "landing_position": 25
      },
      "6": {
        "landing_position": 26
      }
    }
  },
  "questions": {
    "die": {
      "type": "choice",
      "instructions": "Using the current state and discovered board information, choose the die value that you judge will reach square 100 in the fewest total turns, including subsequent turns.",
      "criteria": {
        "1": "Roll 1.",
        "2": "Roll 2.",
        "3": "Roll 3.",
        "4": "Roll 4.",
        "5": "Roll 5.",
        "6": "Roll 6."
      }
    }
  }
}
결과: 50회를 순서대로 실행했습니다.
| 항목 | 결과 |
|---|---|
| 완주 | 50/50 |
| 소요 턴 | 17턴 35회, 18턴 14회, 24턴 1회 |
| 평균 턴 | 17.42 |
| 발견 | 1회차 10턴에 61→20 |
| 50회 종료 시 보유 연결 | 61→20 |
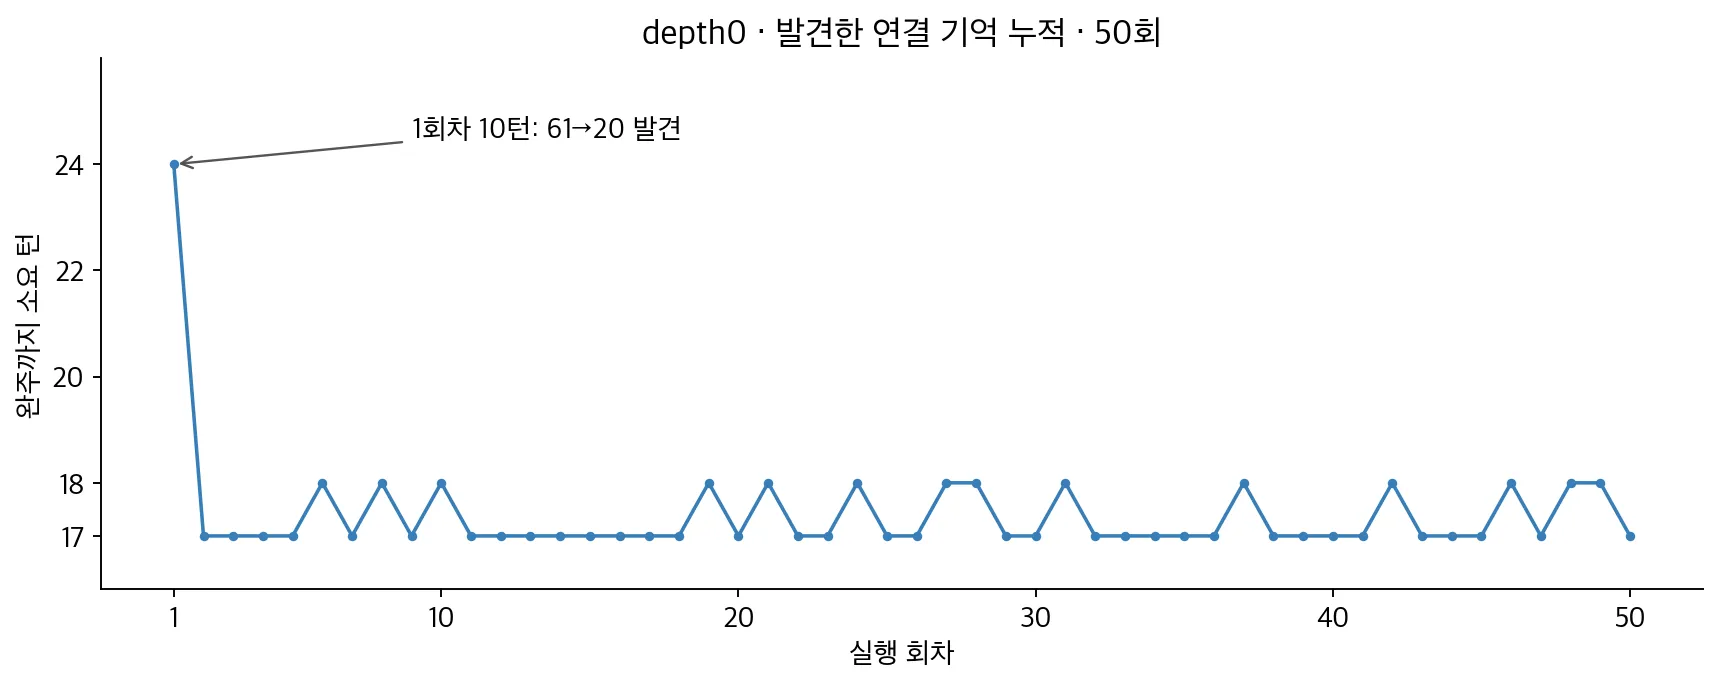
여기에서 Jev가 보드의 전체 상황을 알지 못하는 상황이기 때문에 거의 그리디하게 선택을 했습니다. 그래서 실험 방식을 바꿔 게임판의 특수 이동 정보를 하나씩 공개하는 방식으로 변경해 다시 실험해봤습니다.
4.2 특수 이동을 하나씩 공개
확인 목적: 공개한 연결의 개수에 따라 선택 경로와 완주 턴이 어떻게 달라지는지 확인합니다.
예측: 최단 경로에 필요한 연결이 공개되면 그 연결을 이용한 경로를 선택할 것으로 예상했습니다. 공개 개수별 완주 턴의 수치 예측은 정하지 않았습니다.
입력: 발견 정보와 같은 형식으로 연결을 하나씩 누적 공개합니다. 각 실행 중 제공 정보는 고정하고, 미공개 연결에 도착한 사실은 입력에 추가하지 않습니다. 공개 순서는 아래와 같습니다.
depth0:6→60,61→20,22→100depth1:6→60,61→20,22→80,81→40,42→100
결과: depth0는 0·1·2개 공개 각 1회와 전체 공개 10회, depth1은 공개 개수별 10회를 실행했습니다. 모두 순차 실행했고 모든 회차가 완주했습니다.
| 공개 개수 | depth0 실행 수 | depth0 평균 턴 | depth1 실행 수 | depth1 평균 턴 |
|---|---|---|---|---|
| 0 | 1 | 24.0 | 10 | 24.0 |
| 1 | 1 | 8.0 | 10 | 8.0 |
| 2 | 1 | 8.0 | 10 | 8.0 |
| 3 | 10 | 3.0 | 10 | 8.7 |
| 4 | — | — | 10 | 8.0 |
| 5 | — | — | 10 | 9.0 |
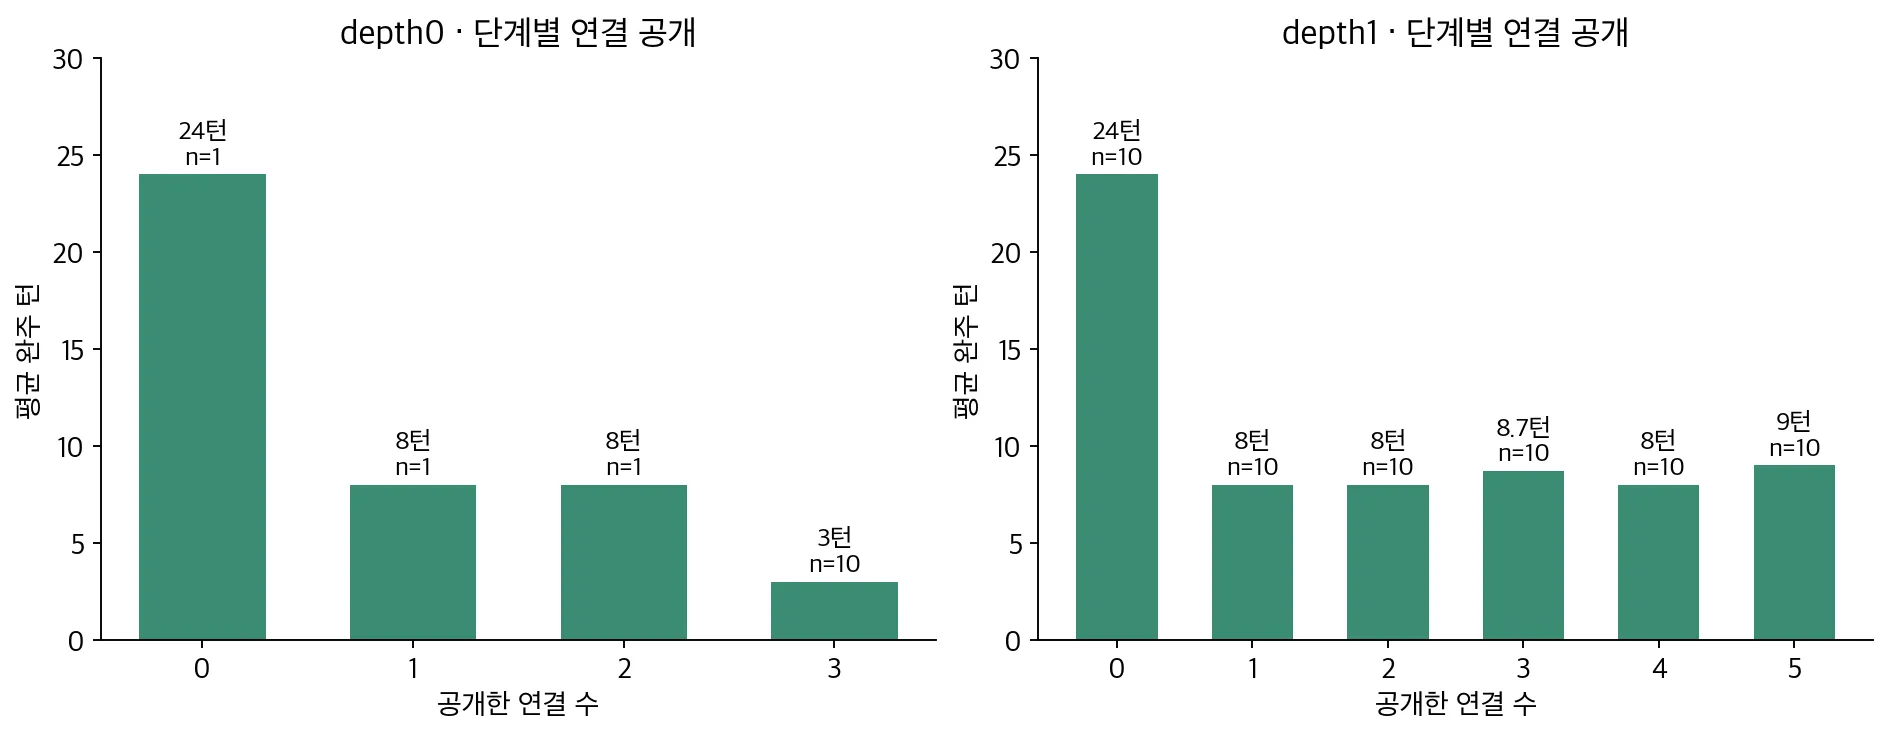
depth0에서는 연결 3개를 모두 공개한 첫 실행부터 최단 경로를 선택했고, 이어진 실행을 포함한 10회 모두 3턴에 완주했습니다. depth1에서는 연결 5개를 모두 공개한 10회의 평균이 9턴이었고, 최단 5턴 완주는 없었습니다.
정보를 순차 공개해도 두 번의 후퇴를 선택해야 하는 경로를 선택하지는 않은 것으로 보입니다.
5. 전체 정보가 주어진 두 방식의 100회 비교
확인 목적: depth1에서 처음부터 모든 정보를 제공한 방식과, 순차 공개의 마지막 단계인 전체 연결 제공 방식을 각각 100회 비교해 완주 턴이 얼마나 다른지 확인합니다.
예측: 전달한 특수 이동 목록이 같으므로 평균 완주 턴도 비슷할 것으로 예상했습니다. 비슷하다고 판단할 허용 차이는 사전에 정하지 않았습니다.
입력: 처음부터 전체 보드를 제공한 기존 100회와, 순차 공개 형식에서 연결 5개를 모두 제공한 신규 100회를 비교했습니다. 신규 100회에는 앞선 10회를 포함하지 않았습니다. 순차 공개 단계의 행동 이력은 넘기지 않고, 마지막 단계의 연결 정보만 모든 요청에 동일하게 제공합니다. 두 방식 모두 실제 연결 5개가 들어 있지만 입력 표현은 다음과 같이 다릅니다.
| 항목 | 전체 보드 형식 | 발견 정보 형식 |
|---|---|---|
| 연결 목록 | board.transitions | memory.known_transitions |
| 특수 이동 5개 | 모두 제공 | 모두 제공 |
| 일반 칸의 최종 위치 | 제공 | 생략 |
| 목록에 없는 칸 | 특수 효과 없음으로 명시 | 특수 이동이 없다고 확정하지 않음 |
| 목표 질문 | 전체 턴을 최소화할 눈 선택 | 현재 상태·발견 정보를 사용해 전체 턴이 최소일 것으로 판단되는 눈 선택 |
| 동시 실행 | 5개 | 1개 |
결과: 두 조건 모두 100회 전부 완주했습니다. 처음부터 전체 보드를 제공한 방식은 평균 7.94턴, 순차 공개 형식의 전체 연결 제공은 평균 9.78턴으로, 후자가 1.84턴(약 23.2%) 더 걸렸습니다.
| 입력 형식 | 평균 턴 | 최단 5턴 완주 | 소요 턴별 횟수 |
|---|---|---|---|
| 전체 보드 | 7.94 | 15/100 | 5턴 15회, 7턴 13회, 8턴 27회, 9턴 40회, 10턴 3회, 11턴 2회 |
| 발견 정보 | 9.78 | 0/100 | 7턴 22회, 9턴 7회, 10턴 27회, 11턴 37회, 12턴 7회 |
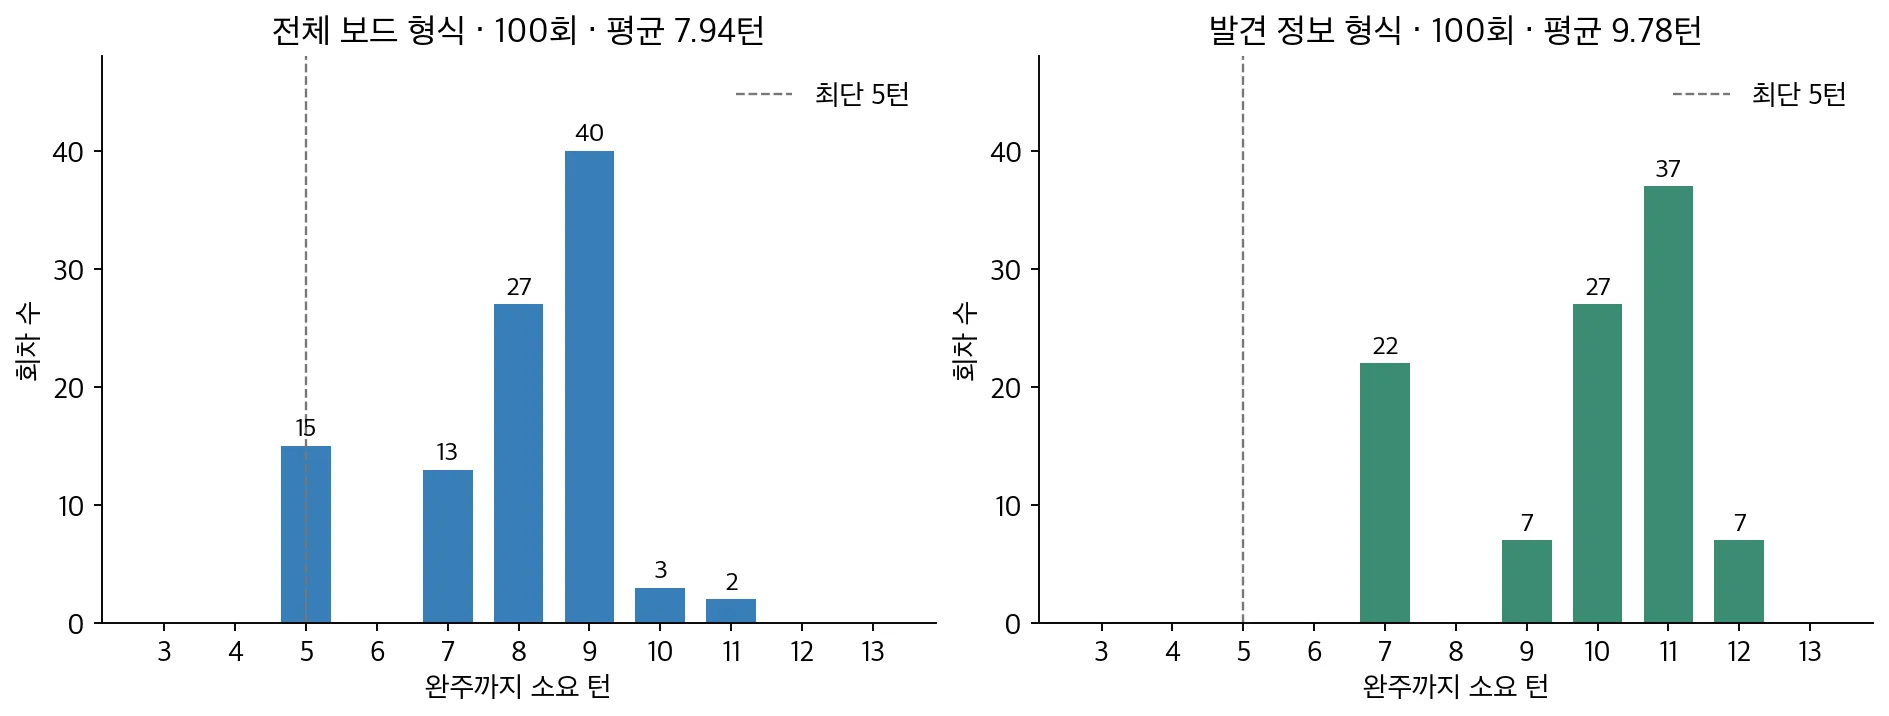
두 조건 모두 최단 경로를 일관되게 선택하지 못했습니다. Jev는 현재 주어진 입력에 대해 최선의 답을 빠른 속도로 결정하지만, 그 선택에 따라 영향을 받는 작업이 연쇄적으로 있는 상황에서는 Jev 보다는 다른 LLM 에이전트나 프로그래밍 로직으로 판단해야 할 것 같습니다.
정리하며
계산된 즉시 결과를 비교하는 greedy 판단은 활용 가능하다고 보았습니다. 또 depth0와 같이 매우 단순한 수준에서의 간단한 계산은 Jev도 가능한 것으로 보였습니다.
다만 depth1부터는 전체 보드를 제공해도 최단 경로 완주가 100회 중 15회였고, 순차 공개 형식으로 전체 연결을 제공한 신규 100회에서는 최단 경로 완주가 없었습니다. 이 결과를 기준으로, 이익을 여러 단계에 걸쳐 연결해야 하는 판단을 Jev에 그대로 맡기기는 어렵다고 판단했습니다.
depth1과 같은 상황에서 Jev가 판단을 내리게 하려면 입력 단계에서부터 ‘두 번 후퇴를 하고 가면 총 N턴이 걸린다 vs 주사위의 최대값만 이용하면 M턴이 걸린다’ 와 같이 매우 구체적으로 조건과 상황을 알려줘야 유의미한 선택을 하게 만들 수 있습니다.
다만 이런 경우에는 Jev에게 맡기는 것보다 프로그래밍으로 처리하는게 더 빠르고 신뢰할 수 있을 것이고 게임에서는 Jev가 선택 분기에 대해 모든 로직을 작성하지 않게 만드는 장점을 가져다 줄 수는 있을 것 같습니다. (매번 행동 트리나 상태 머신으로 관리하는 코드가 없이 선택지와 행동만 있어도 판단은 Jev가 할 수 있으니까요)